解决 Claude Code 接入 DeepSeek 网络难题:Windows 代理配置指南
随着国产大模型 DeepSeek 的兴起,越来越多的开发者尝试在 Anthropic 推出的 AI ...

随着国产大模型 DeepSeek 的兴起,越来越多的开发者尝试在 Anthropic 推出的 AI ...

Anthropic 五月十四号发了一篇长文,叫《How Cl...
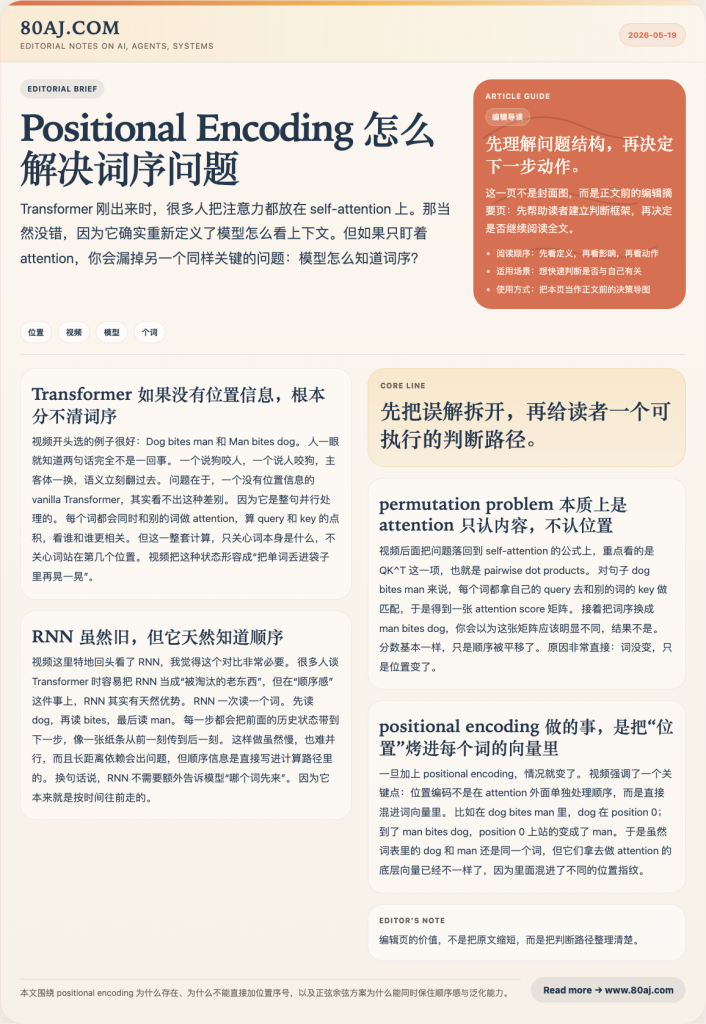
Transformer 刚出来时,很多人把注意力都放在 self-attention 上。那当然没错,因为它确实重新定义了模型怎么看上下文。但如果只盯着 attention,你会漏掉另一个同样关键的问题:模型怎么知道词序? 这是我看完这期视频后最强烈的感受。Transformer 的突破,不只是让每个词都能看见别的词,
近日,开源社区项目 Huainova 宣布正式开放注册。作为一个非商业性质的公益站点,该项目致力于解...
近期在 V2EX 开发者社区中,一篇关于“AI 时代”下开发者行为模式的观察引发了讨论。该文章指出,...
近日,一位开发者在 V2EX 社区分享了一款名为“小红书 Skill”的开源工具,旨在通过安全认证机...

软件模型有过一个很长的阶段:它们能读句子,却不太会“理解句子”。问题不在词表,也不完全在参数规模,而在于早期模型看待语言的方式太像流水线——前一个词处理完,才能轮到后一个词。这样一来,句子一长,前面的信息就会慢慢变模糊。 这就是我看完这期视频后最想记住的一点:Transformer 真正改变局面的地方,不是简单把模型做
一篇发布于技术社区 Linux.do 的讨论帖引发了关于传统开发者职业转型的广泛关注。帖主是一名拥有...
近日,开发者社区Linux.do上的一篇帖子分享了名为《独立站出海营销AI工具》的系列视频教程,重点...
近日,针对谷歌旗下大模型Gemini Pro的访问限额调整在开发者社区引发了广泛讨论。根据Linux...
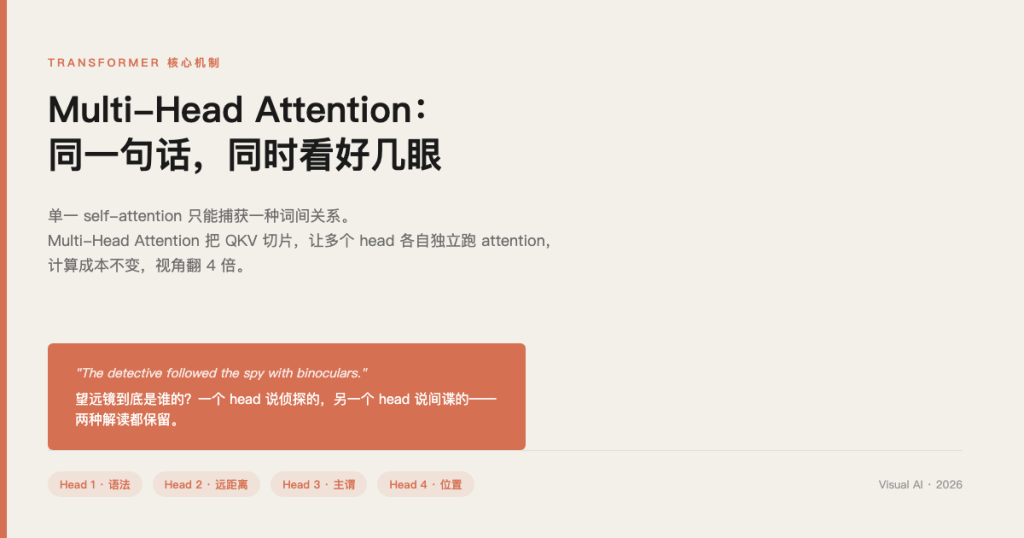
自然语言天生有歧义。 "The detective followed the spy with binoculars." 这句话有两个完全合理的理解:侦探拿着望远镜跟踪间谍,或者间谍带着望远镜刚好被侦探跟上了。人脑能瞬间意识到两种可能,但早期的 AI 模型做不到——它只会 picks up 其中一种,另一种直接丢掉。
一位 V2EX 用户分享了其利用人工智能技术解决育儿痛点的实战案例。面对幼童复杂的饮食禁忌及潜在的过...