AI 让代码评审从看实现转向审结果
AI 开始大规模生成代码后,代码评审需要从逐行检查上移到验证意图、结果和业务影响。本文沿 IBM 的评审演进线,补充运行证据与团队对齐两层工程约束。
AI 开始大规模生成代码后,代码评审需要从逐行检查上移到验证意图、结果和业务影响。本文沿 IBM 的评审演进线,补充运行证据与团队对齐两层工程约束。
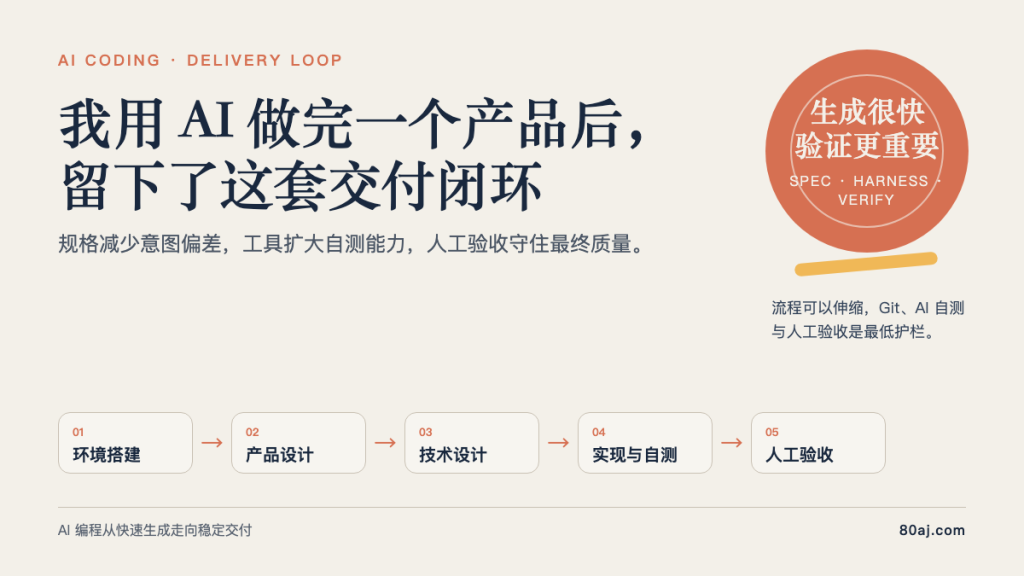
AI 编程可以很快生成代码,稳定交付还需要规格、工具与验证组成闭环。本文用一个电子书阅读器案例拆解五步流程,并说明 Git、AI 自测和人工验收为什么是最低护栏。
DeepSeek Harness 的竞争对象不是某个聊天界面...
很多人第一次用 Cursor,会让 Agent 直接“把这个...
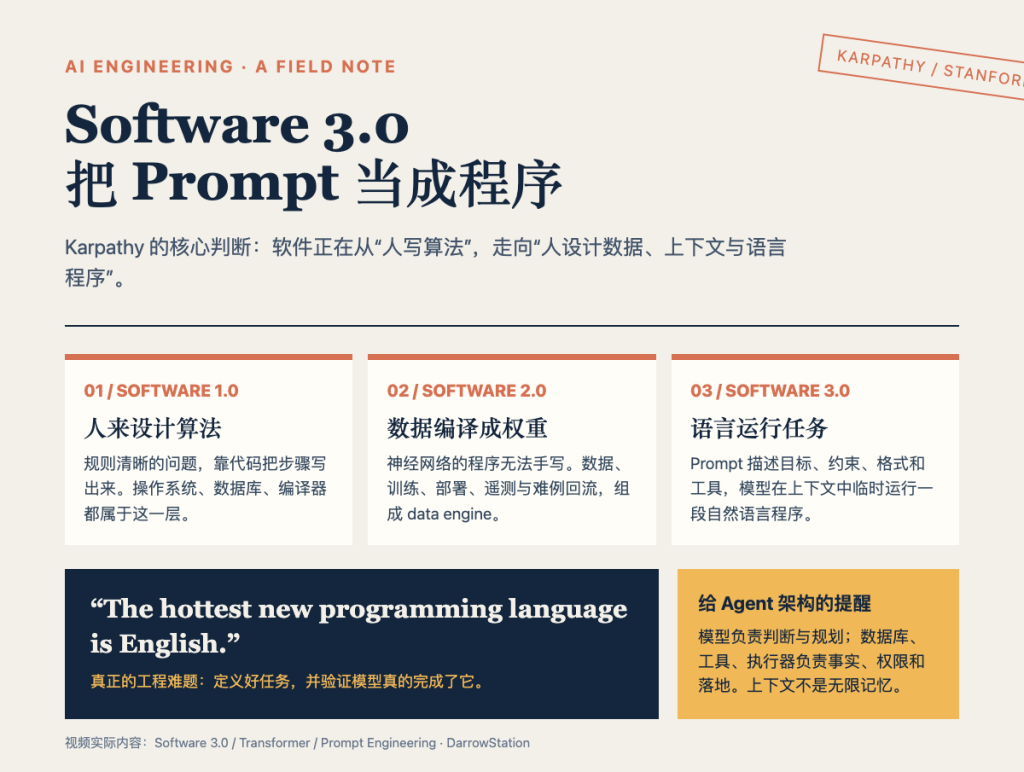
Andrej Karpathy 在 Stanford 的这场演讲,表面上是一场关于 Transformer、GPT 和提示工程的技术分享,真正值得留下的核心判断只有一句:软件正在从“人来设计算法”,转向“人来设计数据和语言程序”。模型能力越强,工程师越需要把注意力从代码细节上移到任务定义、反馈回路、上下文和验证机制上。
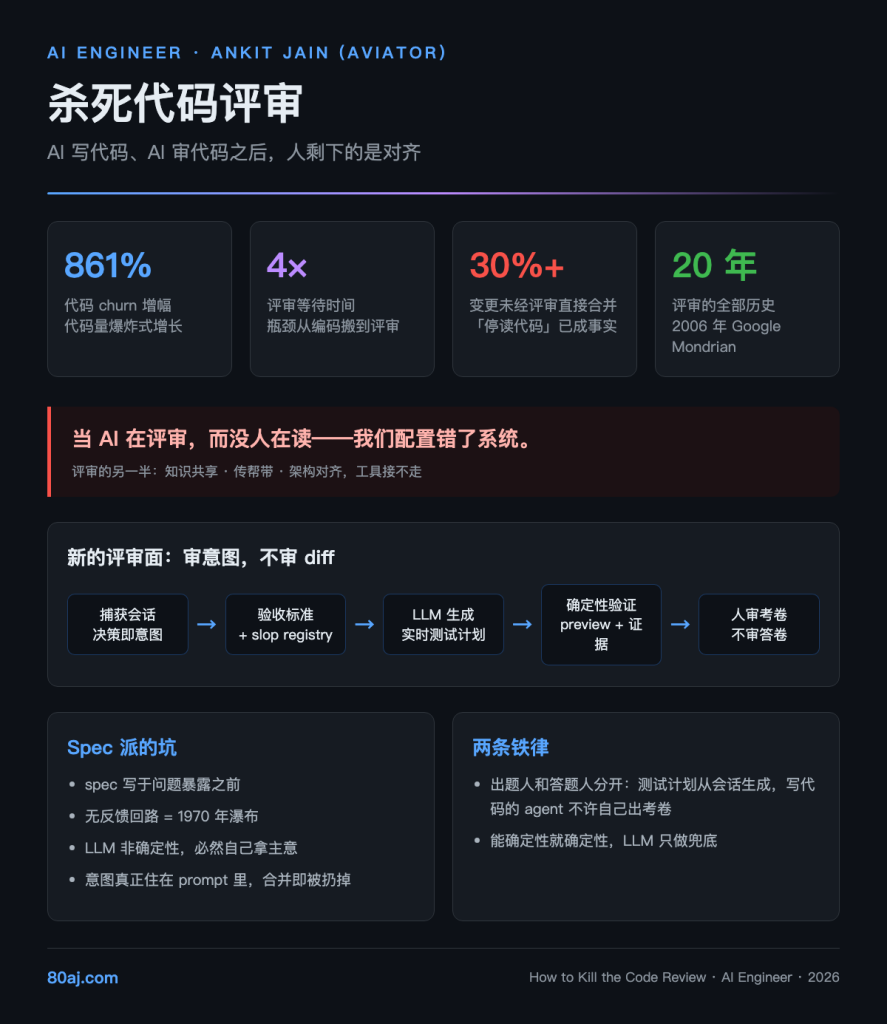
本文整理自 AI Engineer 大会上 Aviator 联合创始人 Ankit Jain 的演讲《How to Kill the Code Review》。他几个月前写过一套「杀死代码评审」的五层信任模型,这次上台主要做自我修正:评审从来不只是抓 bug,它的另一半是知识共享、传帮带和架构对齐——工具能接走前一半,

过去一年里,"让 AI 写测试优先"几乎成了 AI 编程的政...

本文整理自 OpenAI Dominik Kundel 在 AI Engineer World’s Fair 的演讲。它真正值得看的地方,不是 Codex 又多了几个功能,而是 OpenAI 正在把 coding agent 的关键能力从“产品体验”下沉成一套可复用的 harness 与 Responses API 能
公开仓库出现一份被指向 Claude Opus 5 网页端与移动端的长系统提示词。它展示了记忆、版权、工具调用和产品推荐的细颗粒度约束,也提醒 Agent 开发者:能力之外,边界配置才是产品稳定性的底盘。
我越来越怀疑很多“祖传提示词”是在给弱模型打补丁。模型变强后,先把任务说清、把验收做硬,往往比继续堆规则更值钱。
随着Claude 3.5 Sonnet等强模型的发布,传统的提示词工程范式正面临重构。近期有测试显示...
我们一直在以比以往更快的速度迭代!🚀 以下是网页端和移动端的新功能速览: 相关 AI 工程落地时,可用 code80.ai 统一对接多家模型 API,减少重复配置。 • 高级音轨分离 • 将音轨导出为 MIDI • 歌词协作编写与自动保存 • 截图生成歌曲 • Apple CarPlay 与 Android Auto 支持 你最期待 Suno 的哪些新功能?