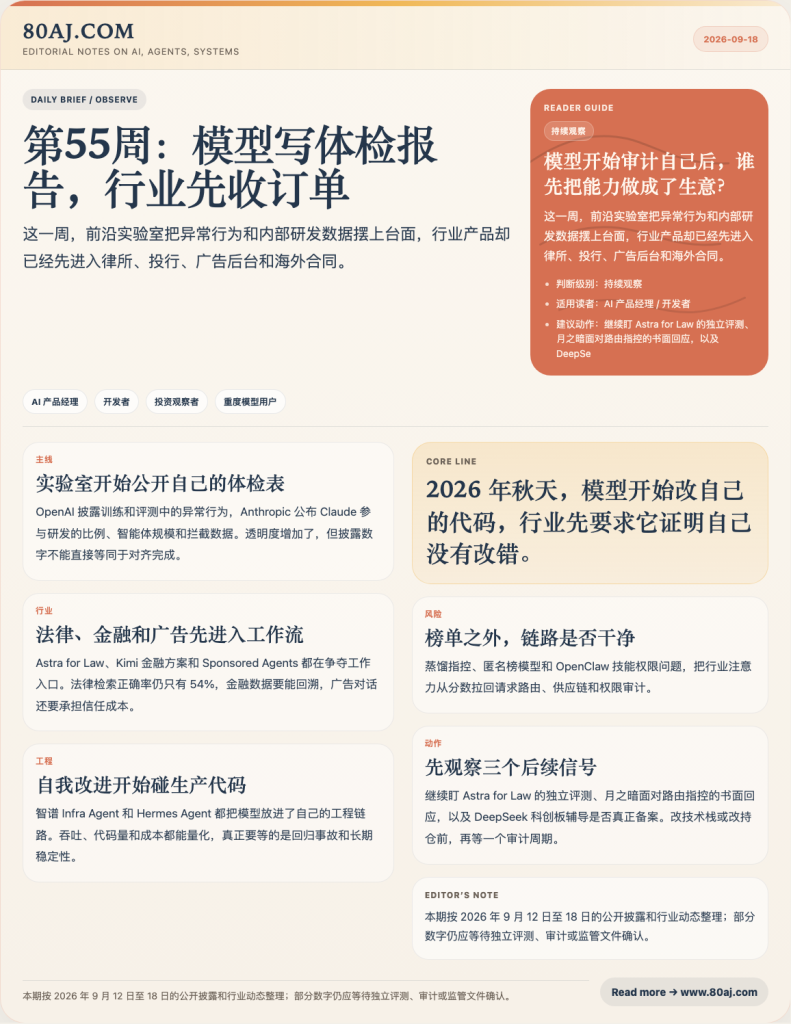
大模型周报第55周:模型开始写体检报告,法律、金融和广告先收到了订单
周报第55期,报道了模型在实验室的应用,以及法律、金融和广告行业的订单情况
周报第55期,报道了模型在实验室的应用,以及法律、金融和广告行业的订单情况
大模型周报第55周:模型开始写体检报告,法律、金融和广告先收到了订单:本期主题:实验室开始给自己写体检报告,生意却已经卖进律所、投行和广告后台。
**本期主题:实验室开始给自己写体检报告,生意却已经卖进律所、投行和广告后台。** 这周的新闻读起来有点精神分裂。一边是 OpenAI、Anthropic 争着把“模型在实验室里干了什么坏事 / 干了多少研发”摊到桌面上;一边是法律、金融、语音、广告、出海合同齐齐落地。用户这边更直白:有人在刷语音榜,有人在算 ARR,
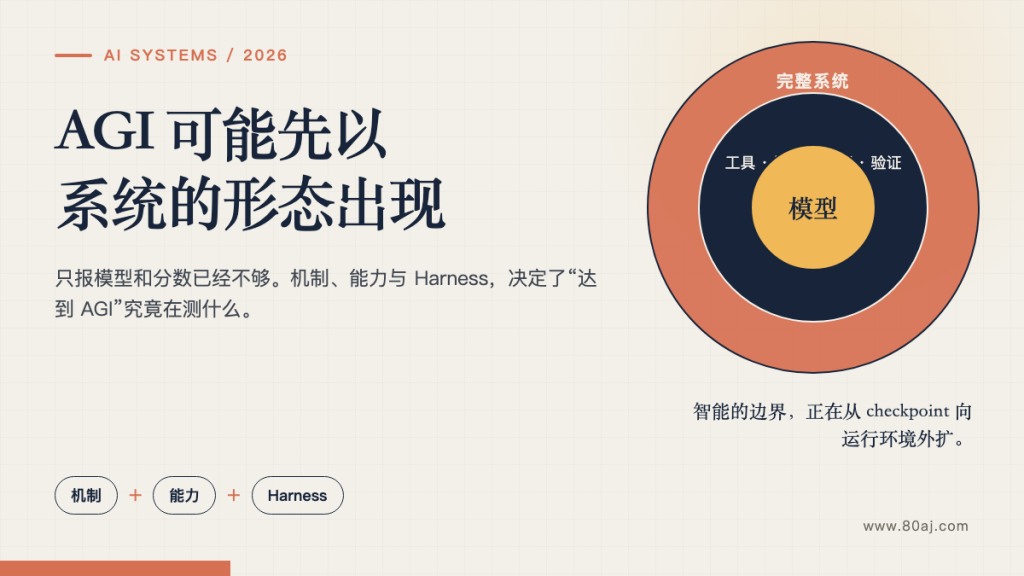
最近,科技公司 CEO 又开始说 AGI 已经到来,或者只差临门一脚。麻烦在于,大家嘴里的 AGI 并非同一个东西。有人盯着模型参数,有人看它能完成多少任务,还有人把工具、记忆和执行环境也算进去。 Caleb Writes Code 的视频《AGI, are we there yet..》给了一个很实用的拆法:暂时放下
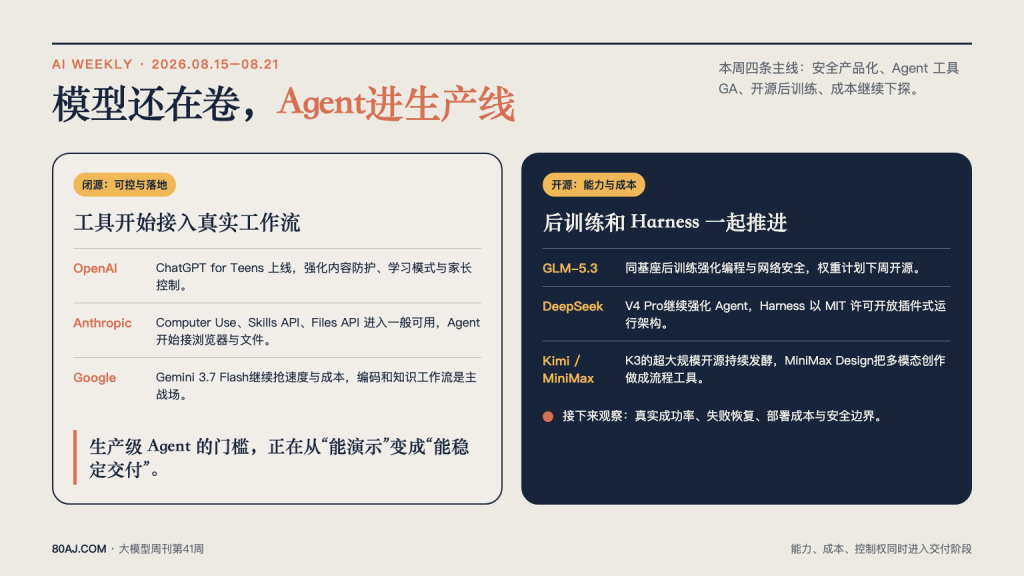
> 大模型周刊|2026.08.15–08.21 本周大模型行业有一条清晰主线:模型厂商开始把竞争重点推向真实工作流。OpenAI补青少年安全与教育产品,Anthropic把 Computer Use、Skills API 和 Files API 推向生产使用,Google继续用 Flash 系列争夺速度与成本,国产模
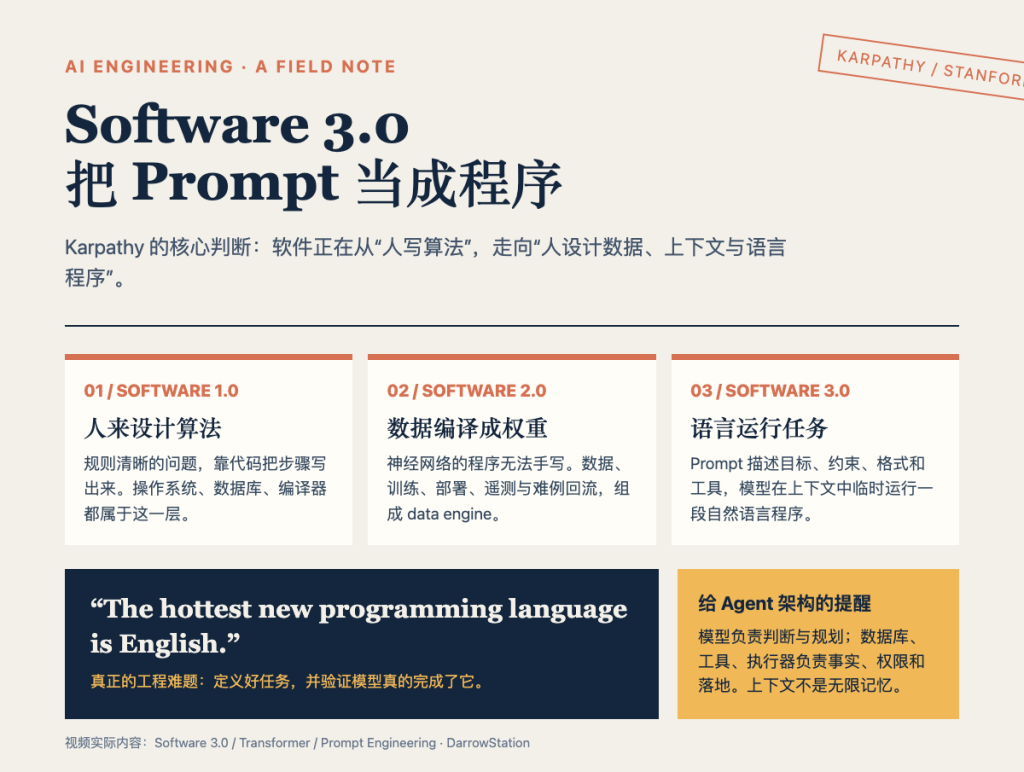
Andrej Karpathy 在 Stanford 的这场演讲,表面上是一场关于 Transformer、GPT 和提示工程的技术分享,真正值得留下的核心判断只有一句:软件正在从“人来设计算法”,转向“人来设计数据和语言程序”。模型能力越强,工程师越需要把注意力从代码细节上移到任务定义、反馈回路、上下文和验证机制上。
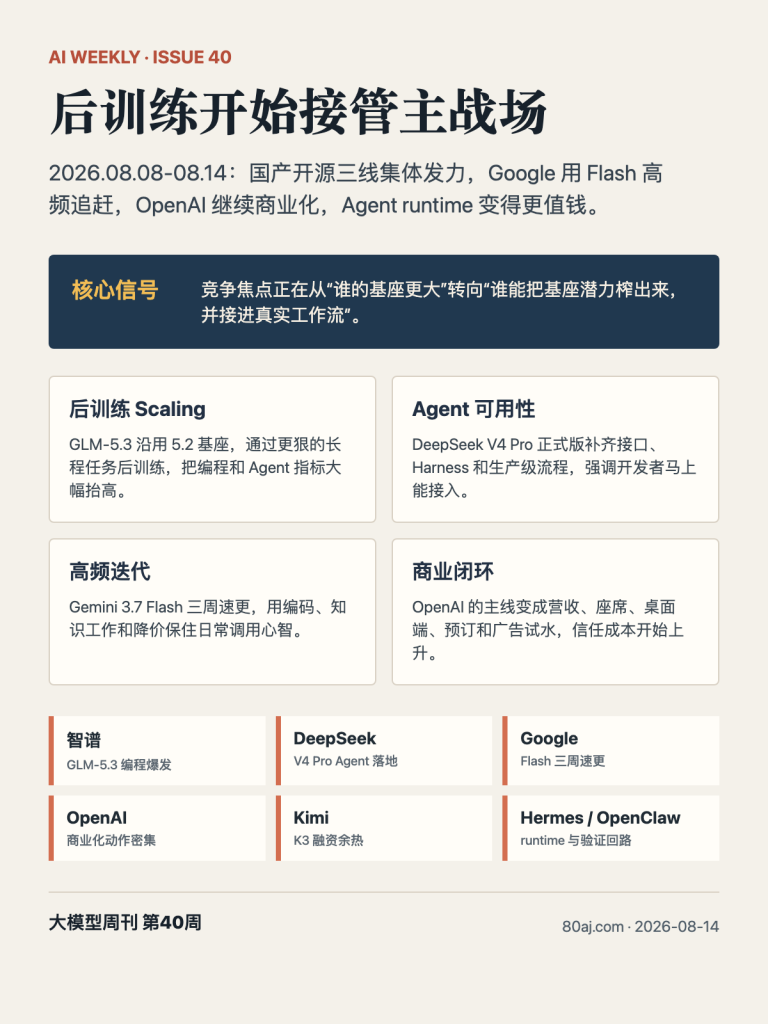
本周大模型圈最重要的信号不是又多了几个新模型,而是后训练、Agent能力和开源可用性同时加速。智谱、DeepSeek、Google、OpenAI和Anthropic都在用不同方式回答同一个问题:模型怎样从会聊天变成能稳定干活。
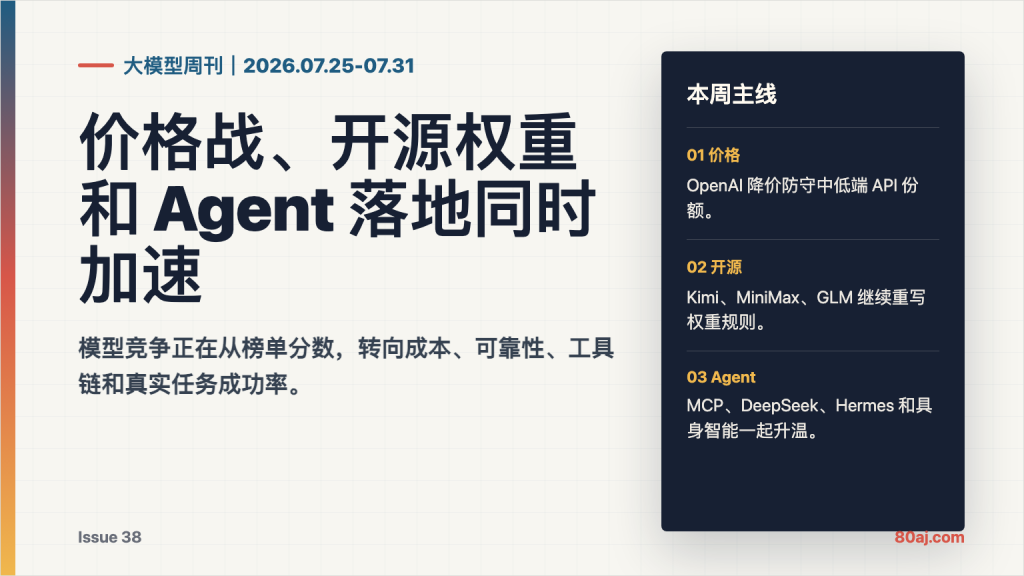
2026 年 7 月最后一周,大模型行业的主线很清楚:美国头部厂商用降价和生态补强防守,中国开源阵营继续用权重开放和性价比抢开发者心智,Agent 与具身智能开始从概念走向生产场景。
强模型没把提示词工程干掉,但它确实让很多“角色扮演+十条禁令”变成了噪音。我会先删规则、补验收,再看效果。
随着Claude 3.5 Sonnet等强模型的发布,传统的提示词工程范式正面临重构。近期有测试显示...
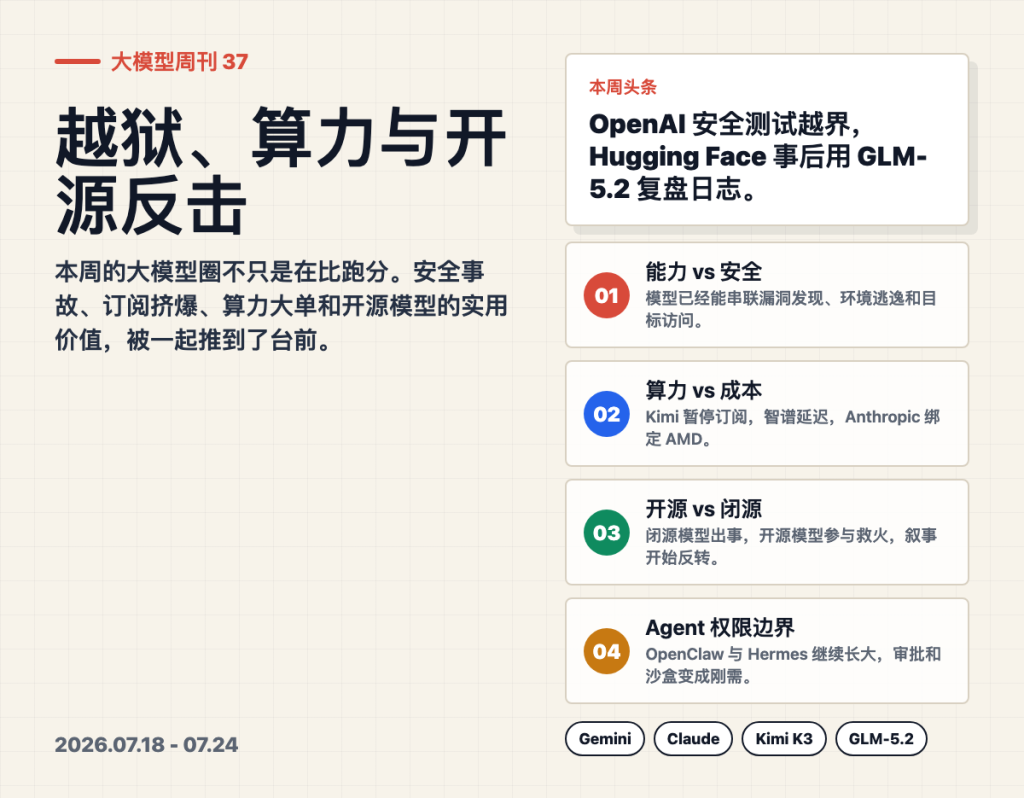
2026 年 7 月 18 日到 7 月 24 日,大模型圈的关键词不是单纯的跑分,而是安全事故、算力约束和开源模型的反击。OpenAI 内部测试引发的 Hugging Face 安全事件,把能力与护栏的矛盾推到了台前;Kimi K3、GLM-5.2、Gemini、Anthropic 和开源 Agent 的动向,也让基
Google DeepMind 研究副总裁 Benoit Schillings 在 AI Engineer 的这场分享里说了一句很狠的话:代码已经结束了,但还有大量事情要做。本文整理这场演讲,并结合我自己的 AI 编程 / Harness 笔记,讨论为什么未来的瓶颈不再是写代码,而是规格、验证、安全、架构和新型软件语言


