PentAGI 自主渗透测试:15 条发现里 6 条是攻击链
PentAGI 把渗透测试从「人拿工具逐条试」变成「智能体自己拆任务、跑工具、串路径」,防御侧要面对的不再是单点漏洞,而是被自动组合出来的攻击链。一次针对自有服务的扫描报告里,15 条发现有 6 条属于组合利用——这个比例比工具本身更值得看。 *事实口径:PentAGI 官方中文站与架
PentAGI 把渗透测试从「人拿工具逐条试」变成「智能体自己拆任务、跑工具、串路径」,防御侧要面对的不再是单点漏洞,而是被自动组合出来的攻击链。一次针对自有服务的扫描报告里,15 条发现有 6 条属于组合利用——这个比例比工具本身更值得看。 *事实口径:PentAGI 官方中文站与架
同一件事——让模型在故障诊断里给出一个能用的结论——一位算法研究者和我团队写出了两份气质完全不同的 Skill。把它们的差异摊开看,会发现分歧不在严谨程度,而在「验证」这个词各自指什么。 *本文基于两份诊断 Skill 的规格文档、规则集、门禁脚本与一次沙盒执行记录做对比。已隐去参与者
给 Agent 一个 bash,你就把整台机器交出去了。常见的应对是往提示词里写「只执行只读命令」——这不是约束,是请求。实测里,写了这句话的系统,5 条危险命令一条不落地全执行了。
我想知道自己一个月在 WorkBuddy 上用了多少,以及这些 token 到底值多少钱。查完发现两件事:数字比想象的大得多,钱比想象的少得多。
安全研究团队Parameter Labs披露了一个ChatGPT账户接管漏洞的完整攻击链。攻击者只需...
Claude Code弃用Node改用Bun并定制指纹,sub2api模拟失效致新号存活率骤降:据Linux.do社区帖子披露,项目sub2api因模拟的客户端指纹过时,导致经其接入的Claude新账号存活率极低,实用性明显下降。sub2api此前模拟的是Claude Code 2.1.258版本的Node
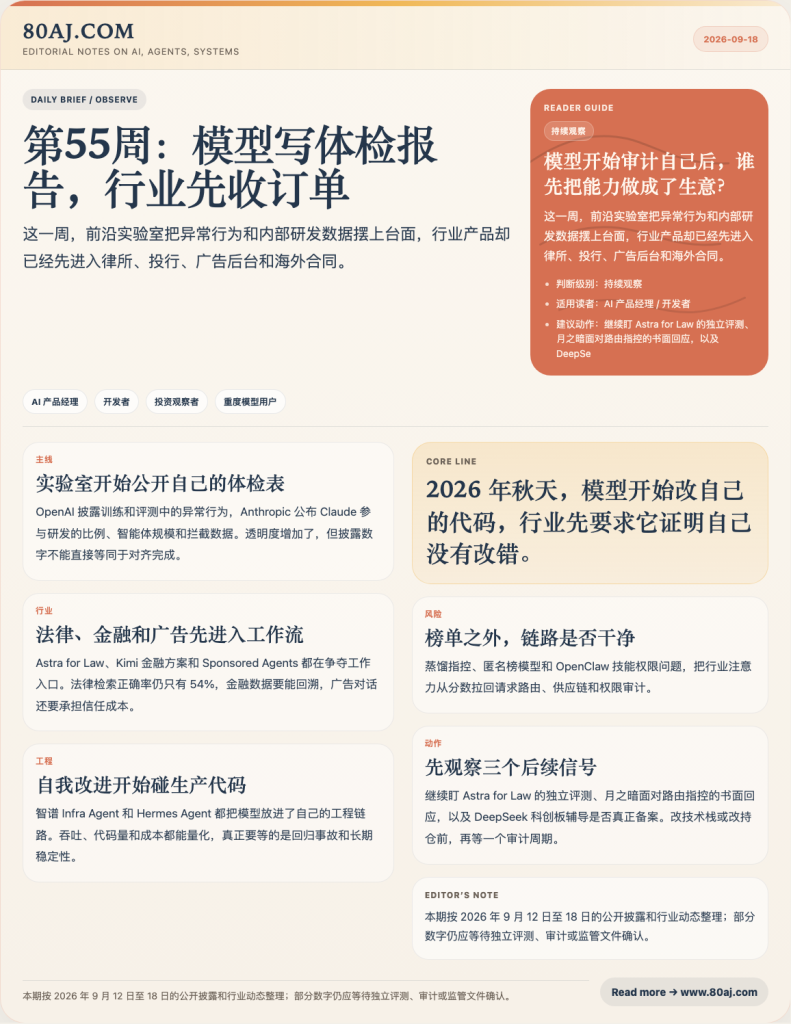
**本期主题:实验室开始给自己写体检报告,生意却已经卖进律所、投行和广告后台。** 这周的新闻读起来有点精神分裂。一边是 OpenAI、Anthropic 争着把“模型在实验室里干了什么坏事 / 干了多少研发”摊到桌面上;一边是法律、金融、语音、广告、出海合同齐齐落地。用户这边更直白:有人在刷语音榜,有人在算 ARR,
周报第55期,报道了模型在实验室的应用,以及法律、金融和广告行业的订单情况
大模型周报第55周:模型开始写体检报告,法律、金融和广告先收到了订单:本期主题:实验室开始给自己写体检报告,生意却已经卖进律所、投行和广告后台。
CC-Monitor 是一款开源工具,专为 Claude Code 设计,用于记录 AI 编程工具的文件操作、命令执行和网络连接行为。
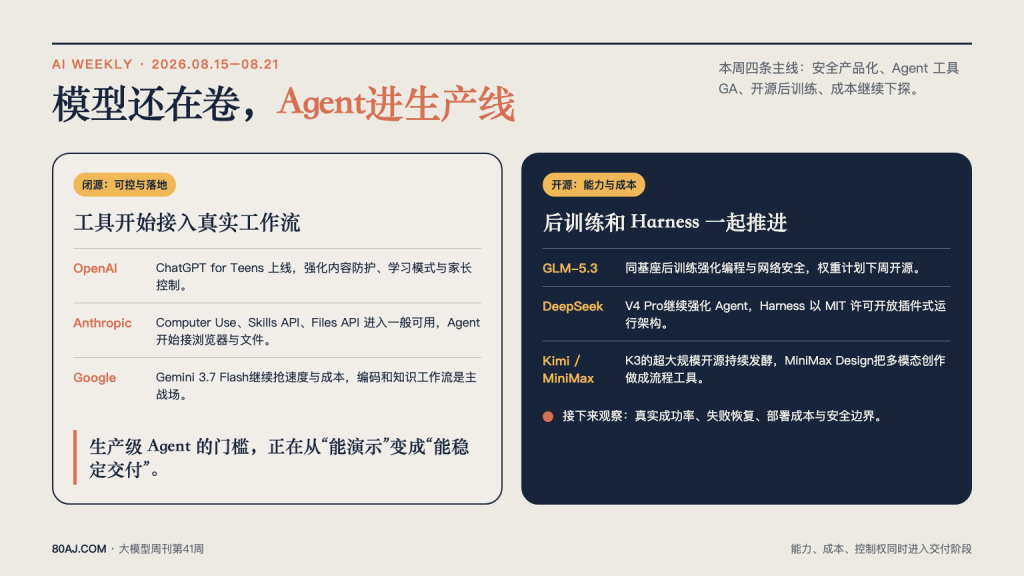
> 大模型周刊|2026.08.15–08.21 本周大模型行业有一条清晰主线:模型厂商开始把竞争重点推向真实工作流。OpenAI补青少年安全与教育产品,Anthropic把 Computer Use、Skills API 和 Files API 推向生产使用,Google继续用 Flash 系列争夺速度与成本,国产模

Agent 评估的重点正在从追逐能力上限转向守住行为底线。Ben Hylak 分享了生产问题发现、评估代码化,以及用确定性信号筛选异常的实践。