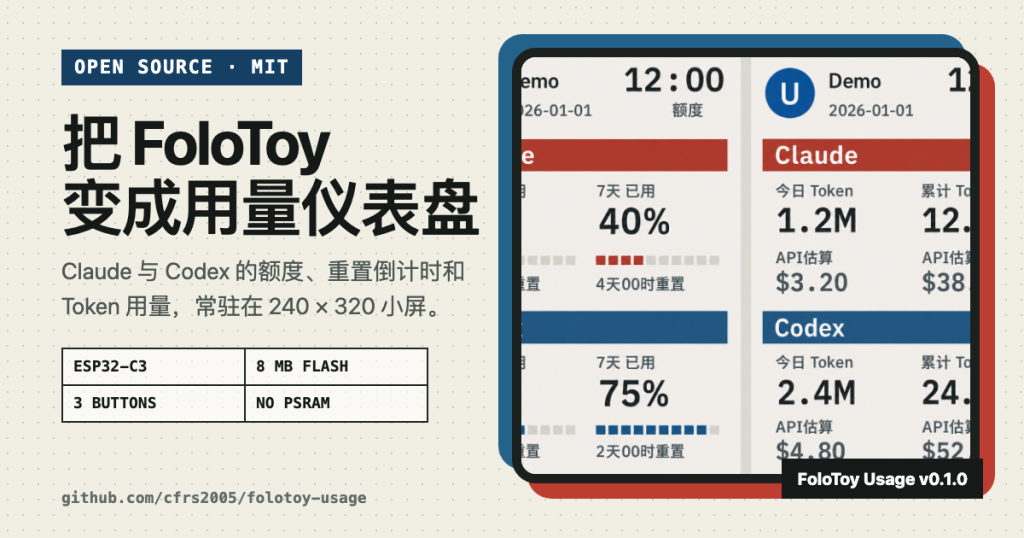
FoloToy Usage 上手:把 AI Passport 变成用量仪表盘
FoloToy AI Passport 有一块 240 × 320 屏幕、三个实体按键和一颗 ESP32-C3。故事机固件之外,这套硬件也很适合做一块安静的桌面仪表。 FoloToy Usage 会显示 Claude 和 Codex 的额度、重置倒计时、今日与累计 Token,以及 API 等价费用。它没有麦克风、TT


一位开发者在 V2EX 分享了利用 Vibe Coding 方式开发的外链管理工具。作者习惯在晚间编写个人项目,此次将日常的产品提交链接流程整合为一个可记录、可筛选、可追踪的外链管理工作台,支持添加项目并方便后续复制粘贴提交。该工具的核心价值在于汇总了 500 多个可提交产品的平台链接。作者在用该工具筛选后发现,自己的产品 ffee.me 实际提交的平台数量远少于预期,此前并未系统性地完成一轮提交。作者坦言工具本身没有突出的技术功能,若不嫌麻烦完全可以手动提交,真正有价值的可能是这 500 多个链接的汇总整理,降低了独立开发者推广产品时的信息收集成本。关于后续计划,作者希望将其做成 skill 插件安装到 AI Agent 上,让 AI 代替人工完成提交,但上网调研后发现多数平台已屏蔽自动化操作,容易触发封号,全自动方案暂时受阻。目前该项目已在 ffee.me/product-submission/ 开放访问,并同步上传至 GitHub 一份,有需要的开发者可以自行下载进行定制修改。对独立开发者而言,这类工作台可用于新产品发布初期的目录站点批量曝光。
核心观点:Vibe Coding 降低了工具开发门槛,但 Agent 自动化的真正边界由平台反自动化规则划定,数据聚合本身即是价值。
原文链接:V2EX 分享发现
一篇发表在《New Review of Academic Librarianship》期刊、关于盗版电子书库Z-Library的学术论文,被科技媒体TorrentFreak发现引用了一篇根本不存在的TorrentFreak文章。经逐一核查,这篇由两位尼日利亚大学图书馆员撰写的论文,44篇参考文献中至少有10篇无法找到,包括声称刊载于《哈佛法律与技术期刊》的Daniel Gervais文章、被错误署名给学者Carol Tenopir的论文,以及一份不存在的卡巴斯基报告。这些虚构引用的共同特点是:引用真实的出版物、机构与学者,标题和上下文看似合理,实则查无此文。论文致谢部分披露,作者使用Consensus AI筛选文献并提取信息,使用ChatGPT润色语言。AI检测工具Pangram对论文摘要和结论的检测结果为’100%可能由AI生成’。出版商Taylor & Francis回应称,已将此事移交编辑与出版伦理及诚信团队调查,论文是否被更正或撤稿尚待观察。事件颇具讽刺意味:这篇批判Z-Library损害学术出版可持续性的论文疑似AI大量代笔,而版权方正因AI公司利用影子图书馆训练模型而提起诉讼,且论文回避了同行评审者通常无偿工作这一争议焦点。
核心观点:当AI编造的引用能穿透同行评审,学术出版的信任根基正被生成式AI从内部瓦解。
原文链接:Hacker News
veil是一款开源数据脱敏工具,代码托管于GitHub(Mouseww/veil),核心功能是在开发者将代码或文本提交给大语言模型处理前,自动将手机号等敏感信息替换为占位符,防止隐私数据泄露给模型服务商。近期有用户反馈,该工具在不同模型上的表现存在显著差异。在OpenAI模型上,脱敏机制运行良好:即使用户要求模型复述手机号,模型也只会原样返回占位符,不会试图还原或编造真实信息。然而在Claude Code环境中使用Claude系列模型(用户提及Opus版本)时,该方案似乎失效——由于模型无法读到明文数据,它倾向于直接拒绝执行相关操作,导致工作流中断。发布者推测这是模型安全机制将无法理解的占位符输入视为异常所致,并在Linux.do论坛发帖征求社区建议,希望找到合适的提示词规则或配置修改方案,使Claude模型能够正常处理脱敏后的数据。该话题目前处于讨论初期,反映了AI编程场景下数据隐私保护落地的真实痛点。
核心观点:模型安全对齐越严格,对脱敏数据的容忍度反而越低,隐私保护工具的落地正卡在模型行为差异这道隐形门槛上。
原文链接:Linux.do
Linux.do论坛一位开发者分享了同时使用GPT、Claude、Gemini三大模型进行编程协作的实践经验。作者认为早期CCS等多模型协作项目过于笨重、方案死板,实际工作中更应根据各模型特点灵活分工。根据其使用体验:GPT系列模型是“细节狂魔”,写出的代码基本一轮通过、bug率低,排查问题能力显著强于其他两家,但存在过度工程化、防御性编程过多、生成速度慢、表达机械、前端质量差等短板,适合负责后端架构维护及审查其他模型的方案漏洞。Claude Opus系列被评价为均衡型模型,几乎没有明显短板,表达自然,可放心承担主要开发工作,但编码中可能遗漏细节,需配合Codex审查方案后一轮通过验收。Gemini系列则被认为最具灵性、人机交互体验最佳,前端能力尚可,但执行时容易丢三落四,直接干活的能力约相当于DeepSeek。作者计划将Gemini设为主模型,由其调度Claude Code和Codex完成具体施工,以规避Antigravity在harness能力上的缺陷。作者目前效率最高的工作流是以Claude Code为主力,施工前让Codex审核方案,并由Claude Code直接调用Codex CLI完成审核,同时向社区征求更多多模型协作经验。
核心观点:AI编程正从单模型能力比拼转向多模型编排竞争,谁能做好“包工头”式调度层,谁就掌握下一代开发入口。
原文链接:Linux.do
Linux.do社区一则讨论帖聚焦当前AI编程Agent的使用成本与渠道选择问题,引发开发者关注。发帖人称其日常任务每日消耗数亿Token,即便使用DeepSeek V4.1并将缓存命中率提升至98%,成本压力依然显著。除价格因素外,该用户还指出部分API中转服务稳定性欠佳,容易造成上下文污染,影响Agent任务的执行质量。帖子附带的投票列出了目前主流的AI编程Agent选项,包括OpenAI的Codex、Anthropic的Claude Code、DeepSeek Harness、开源项目OpenCode、Pi WorkBuddy、智谱ZCode(搭载GLM-5.3官方Harness)以及月之暗面Kimi Code(搭载Kimi K3.1 Pro,覆盖CLI、VS Code插件、桌面客户端等多种工具形态)。在模型渠道方面,投票提供了中转API与官方订阅两个选项,直指开发者群体在成本、稳定性与合规之间的普遍纠结。该帖反映出AI编程工具使用中的一个典型矛盾:Agent类应用对Token的消耗远超传统对话场景,动辄以亿计的调用量使推理成本成为核心考量;而中转API虽然价格更低,但稳定性与上下文一致性难以保障。缓存命中率、模型定价、渠道可靠性等因素,共同构成了开发者选择技术方案时的权衡矩阵。
核心观点:AI编程竞赛正从模型智力转向Token经济学,缓存优化与渠道稳定性成为争夺开发者的隐形战场。
原文链接:Linux.do
据推特用户@log4j发布的安全研究发现,三星电视内置了多层用户监测机制。电视具备自动内容识别(ACR)、地理定位、网络映射、定向广告和用户画像等功能,设备中加载了按地区区分的卷积神经网络文件(如LogoCNN.bin、cnn.mapping),用于分析各类应用中的使用行为,包括用户在YouTube上观看了什么内容、跳过了哪些广告以及视频播放进度等细粒度数据。在音频方面,系统能够识别狗叫、婴儿哭声等声音事件,并将相关信息上报给三星。值得注意的是,即使电视本身没有配备麦克风,系统也会主动寻找带有麦克风的连接设备,例如音响或蓝牙设备。研究还发现电视会启动一个名为rmdemon的服务,该服务能够启动网络数据包记录。此外,代码中存在与人脸识别相关的部分,其输出包括人脸边界框,并提及连接摄像头后的预览功能。研究者推测,电视运行卡顿的部分原因可能是音频、截图等数据在本地进行处理所致。该发现最初由推特用户@log4j发布,目前在Linux.do社区引发讨论。
核心观点:当客厅大屏成为全天候数据采集终端,智能电视的商业本质已从硬件销售转向注意力与隐私的双重变现。
原文链接:Linux.do
