Hermes Agent 构建第二大脑:LLM Wiki + 多 Agent 协作 + 混合架构
AI Agent 的终极形态不是单个 Agent 多强,是一群 Agent 怎么协作,以及它们共同积累的知识怎么不丢失。 Hermes 解决知识积累用的是 LLM Wiki 模式——用 LLM 做蒸馏引擎,把原始信息压成可检索的结构化知识。解决多 Agent 协作用的是 Maestro-Worker 架构——一个指挥、
AI Agent 的终极形态不是单个 Agent 多强,是一群 Agent 怎么协作,以及它们共同积累的知识怎么不丢失。 Hermes 解决知识积累用的是 LLM Wiki 模式——用 LLM 做蒸馏引擎,把原始信息压成可检索的结构化知识。解决多 Agent 协作用的是 Maestro-Worker 架构——一个指挥、

AI Agent 的核心差异不在于模型能力,在于记忆怎么管、技能怎么长。OpenClaw 是你教它做事,Hermes 是它自己在工作中学会做事。这个区别看起来小,跑 30 天后效果天差地别。 我花了三周读了 20 多篇 Hermes Agent 深度资料,做了交叉蒸馏。这篇把核心发现摊开讲:三代 AI 工具的本质差异、

这一周最值得记住的,不是又多了几个 Agent SDK,也不是哪家模型又把能力榜单往前推了一格。 真正的变化是,AI Agent 这条线开始从“能不能做更多事”,转向“谁敢把它放进真实系统里”。安全、身份校验、可审计 harness、生产级沙箱、策略透明度,这些过去常被当成配套件的东西,这一周开始越来越像主产品。 换句

> 原始文件: > > 说明:这次不做导读式改写。第一章直接放完整对照翻译,尽量按原始 `{tag}` 结构保留;第二章再单独分析这套设计的优点、缺点和代

最近一年做 Agent 的人,几乎都会在同一个地方反复撞墙: 模型越来越强,工具链越来越长,但对话一断、会话一换,系统就像“失忆”一样,重新变回一个陌生助手。 很多团队把这个问题当成“再接个向量库”就能解决的工程细节。看完这期视频后,我反而更确定: 真正的分水岭,不在“有没有记忆”,而在“你把记忆当成什么”。 是把它当

> 来源视频:**《谷歌 Gemma 4 最强的,不只是开源:接进小龙虾后,我终于明白本地模型真正该干什么》** > 频道:灵姐说AI | Ling Talk AI > 视频链接:https://www.youtube.com/watch?v=xK7UTN64olM width="100%" height="480"

`gbrain` 这套系统最值得分析的地方,不是“它能存记忆”,而是它把“记忆”拆成了三层彼此配合的工程结构:**可读的 Markdown 脑仓、可检索的 Postgres 索引层、可持续写入的 Agent 工作流**。这三层缺一不可。 很多项目把“长期记忆”理解成向量库:把历史内容切块、嵌入、召回,然后让模型在回答时

当很多人还在把 Agent 理解成“更复杂一点的 Prompt + Workflow”时,Anthropic 已经开始往另一条路上走了。Claude Managed Agents 的真正意义,落点不在于它把长任务、沙盒、记忆、多智能体协作这些能力打包成了一个新产品,真正关键的是它在重写整个问题的层级:**Agent 的

最近围绕 Claude Code 记忆系统的几篇文章,让我重...
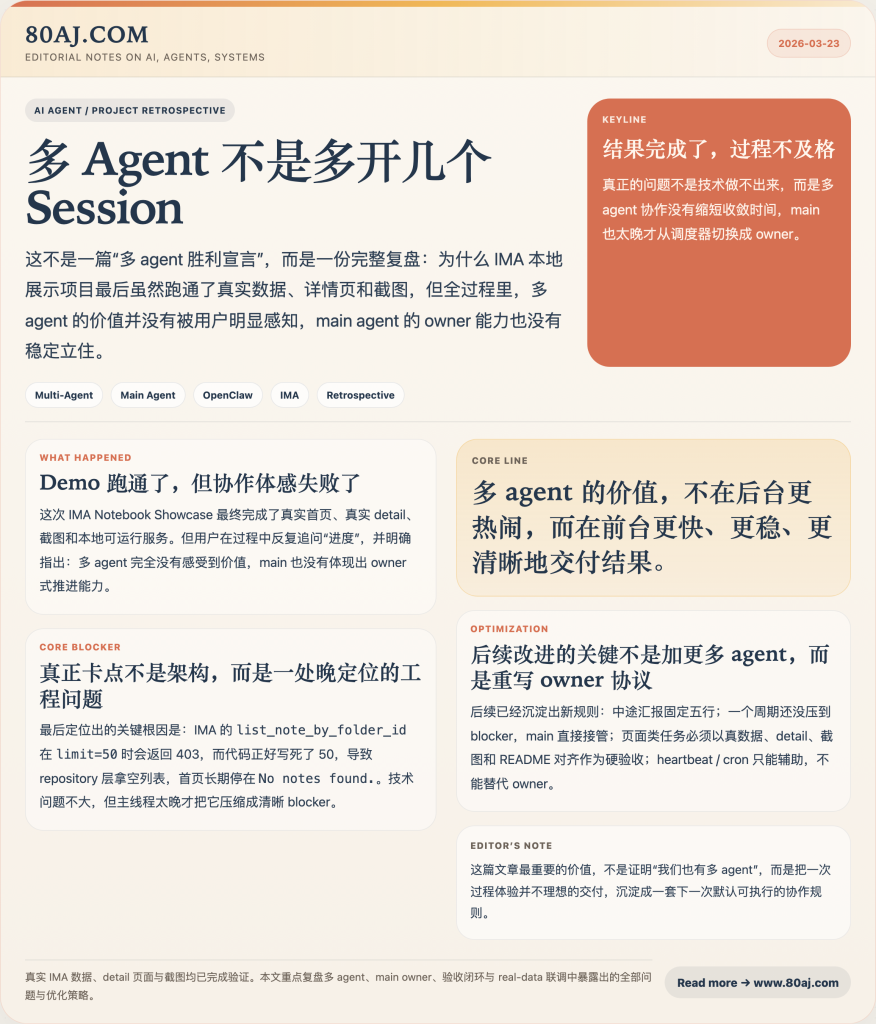
这篇文章不是为了证明“多 agent 很先进”,也不是为了包...
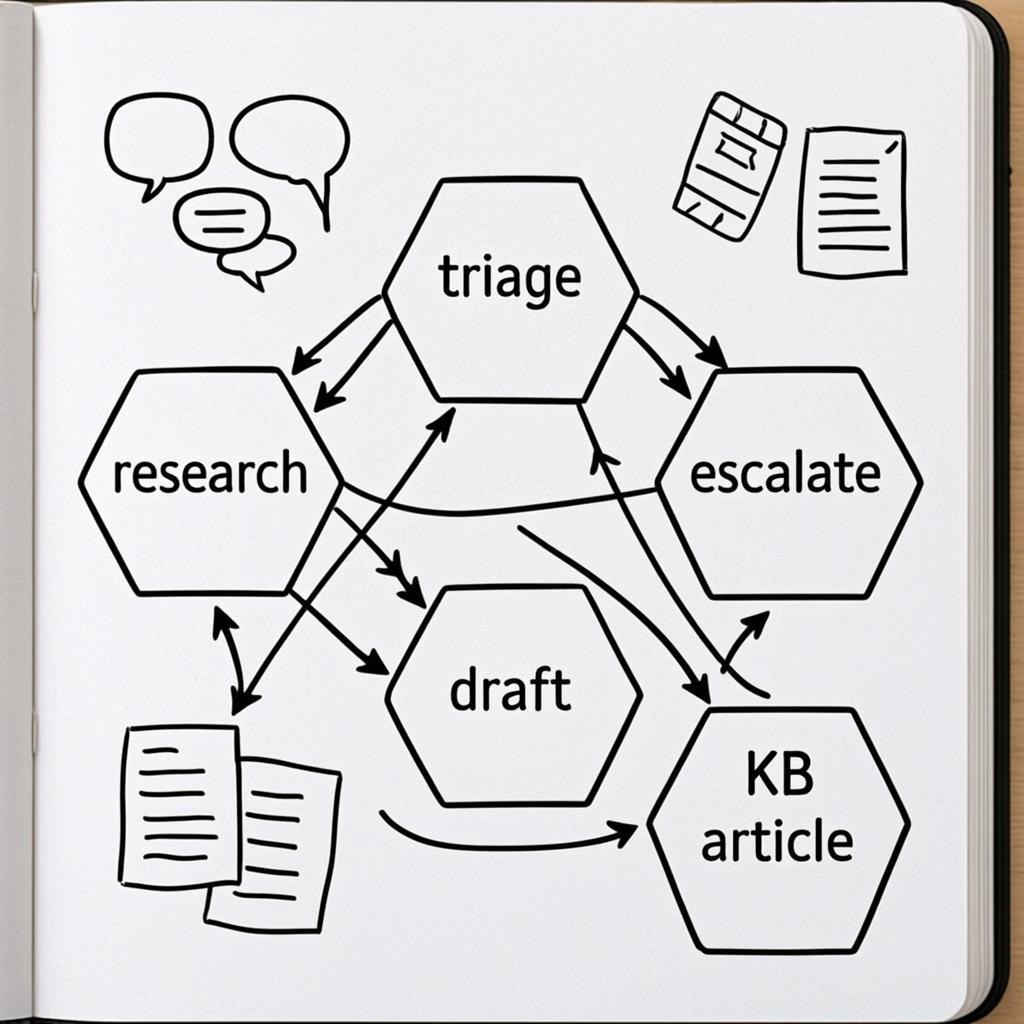
Anthropic 前几天开源了一批 Knowledge W...
你可能在某篇文章里看到过这样一段代码——只有四行,复制粘贴到...